Transformer学习笔记
此文为本人学习b站up主RethinkFun的视频的笔记,表达上不具科普效果,有点抱歉
Tokenize
即分词,把一句话分成若干个词。
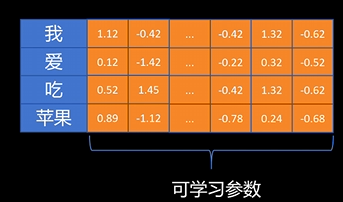
这些可学习参数就是Embedding。
Embedding
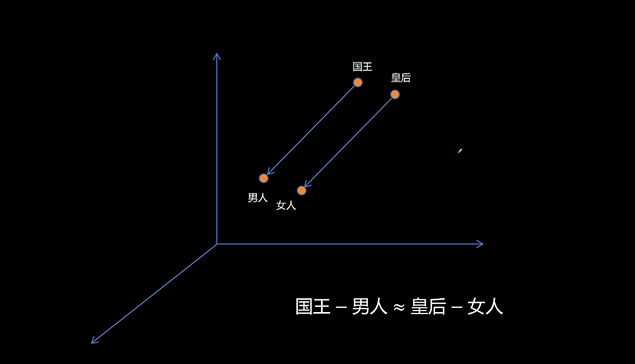
Embedding的每一个维度可以认为代表不同的语义,可以有很多维度。
Self-attention
主要是Q,K,V:
- Q 表示的是向其他token查询的向量。
- K 表示应答其他token查询的向量。
- V 表示更新其他token的embedding的向量。
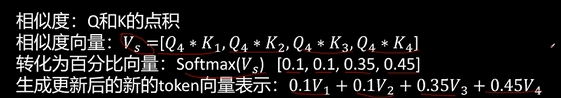
Q和K先匹配,获得相似度,然后进行softmax,这样就先算出该单词和其他单词的相似度,接着根据这个相似度就可以重新使用大家的V来进行该单词的重新表达。
可以类比为查字典的过程,K是字典里面的关键词,Q则是查询,V是字典里面关键词对应的内容。
简单说:Q 和 K 负责 “选哪些词重要”,V 负责 “把重要的词的信息整合起来”。
MultiHead-attention
其实就是多个自注意力机制,8组qkv获得8组v向量后拼接起来,于是得到了下面这个公式。
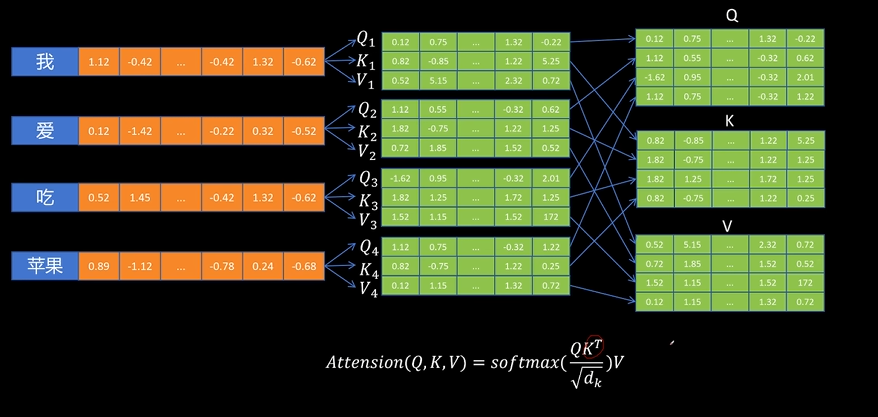
Q乘以K的转置就算出了刚才所说的相似度,用这个相似度进行softmax,再乘上V进行attention的表达。
Add & Norm
Add就是残差连接,用于解决多层网络训练的问题。
Norm指的是Layer Normalization,在transformer里面是做单个单词的归一化。
Transformer 某一层的输入张量通常为 [batch_size, seq_len, hidden_dim]:
- batch_size:批次内样本数量(多少个句子)
- seq_len:句子的单词数量(比如每个句子有 3 个词);
- hidden_dim:每个单词的特征维度(比如 BERT-base 的 768 维,这是模型学到的语义特征)。
这里的归一化只对hidden_dim做。
而如果是BN(Batch Normalization),则是在batch_size的维度做,一个批次内所有样本的同一个特征维度做归一化。
不管是 CV(CNN)还是 NLP,BN 的输入张量通常可统一为:[batch_size, feature_dim1, feature_dim2, …]
- CV 场景(CNN):[batch_size, channels, height, width](比如 [4, 3, 32, 32]:4 张图、3 通道、32×32 像素);
- NLP 场景(对比 LN):[batch_size, seq_len, hidden_dim](比如 [4, 3, 4]:4 个样本、3 个词、4 维特征)。
BN 的归一化维度
BN 的核心是在batch_size维度上计算均值 / 方差,且针对 “同一个特征位置”:
- CV 中:对「所有样本的同一个通道、同一个像素位置」归一化(比如 4 张图的 “第 1 通道、第 5 行第 5 列” 像素);
- NLP 中(对比 LN):对「所有样本的同一个词、同一个特征维度」归一化(比如 4 个样本的 “第 2 个词、第 3 维特征”)。
这里为什么使用LN而不是使用BN?我觉得可以从NLP任务的角度进行理解,如果使用BN,现在来了两个句子进行训练,两个句子同一个地方的词的同一个特征要做归一化,但是这两个句子根本就没任何关系,这样训练出来反而互相影响了。而使用LN,只在单词内部进行归一化,不会有影响。比如小猫吃鱼和火箭发射,居然要把小猫和火箭一起归一化,实在是诡异,会造成不同句子间的特征干扰。因此使用LN。
Feed Forward
全连接层。
第一层激活函数是Relu,第二层不用激活函数。
Position Embedding
位置编码是为了利用单词的位置信息,因为NLP中语义顺序很重要。
对于偶数维度,位置编码公式为:
\[PE_{(pos,2i)} = \sin\left( \frac{pos}{10000^{2i/d}} \right)\]对于奇数维度,公式为:
\[PE_{(pos,2i+1)} = \cos\left( \frac{pos}{10000^{2i/d}} \right)\]这里的pos是词在序列中的位置,i是维度索引,d是位置编码向量的总维度(和词向量维度一致)。
可以让模型容易地计算出相对位置,对于固定长度的间距 k,PE(pos+k) 可以用 PE(pos) 计算得到。因为 Sin(A+B) = Sin(A)Cos(B) + Cos(A)Sin(B), Cos(A+B) = Cos(A)Cos(B) - Sin(A)Sin(B)。这样可以通过数学捕捉到相对位置关系。